Guías y análisis
AMD Ryzen AI Max+ 395 (Strix Halo) para IA local: lo que hay que saber
Qué es el Ryzen AI Max+ 395, por qué sus 128 GB de memoria unificada lo hacen especial para la IA local, cuánto rinde con LLM según pruebas publicadas y dónde están sus límites.
En resumen
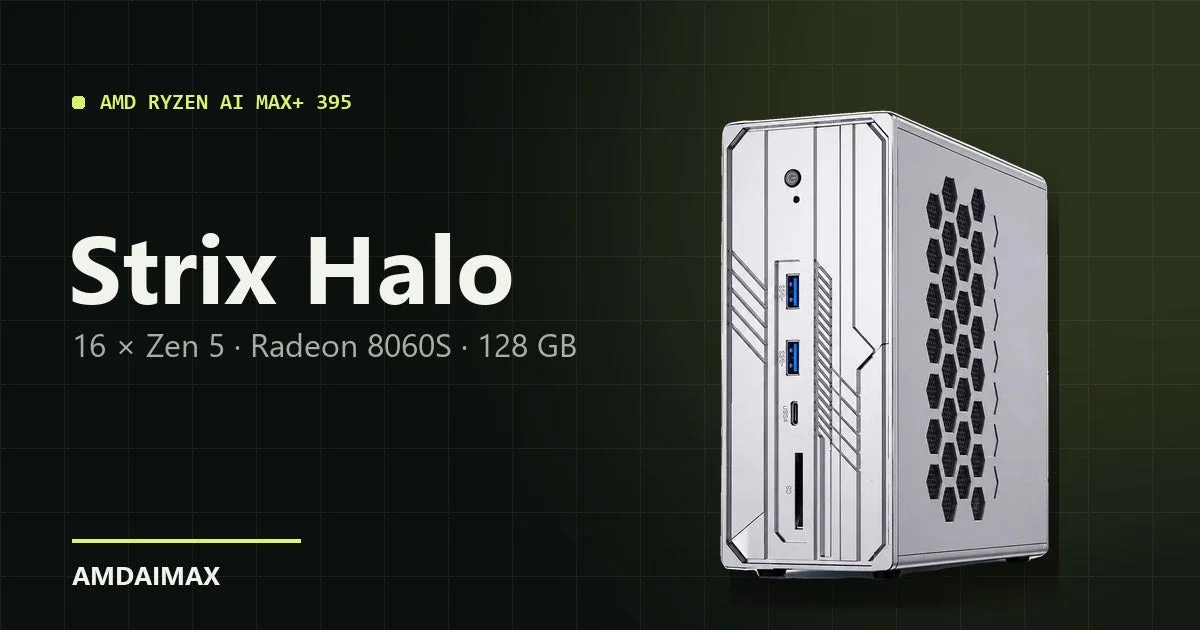
- Reúne 16 núcleos Zen 5, una gráfica Radeon 8060S de 40 unidades de cómputo y una NPU de 50 TOPS en un solo chip, con hasta 128 GB de LPDDR5X-8000 compartidos (256 GB/s).
- En Windows la gráfica puede usar hasta 96 GB; en Linux el límite se amplía con la herramienta amd-ttm de AMD.
- Va muy bien con modelos MoE (gpt-oss-120b supera los 50 tokens/s) y es lento con modelos densos grandes y con prompts muy largos, comparado con NVIDIA.
Especificaciones oficiales
El Ryzen AI Max+ 395 es el modelo más alto de la serie Ryzen AI Max 300 de AMD, conocida por su nombre en clave «Strix Halo». Estos son sus datos según la ficha oficial de AMD:
| Característica | Ryzen AI Max+ 395 |
|---|---|
| Núcleos e hilos | 16 / 32 (Zen 5) |
| Frecuencia | 3,0 GHz base · hasta 5,1 GHz |
| Caché | L2 16 MB · L3 64 MB |
| Gráfica integrada | Radeon 8060S · RDNA 3.5 · 40 unidades de cómputo · 2900 MHz |
| NPU | XDNA 2 · hasta 50 TOPS |
| Rendimiento IA total | Hasta 126 TOPS (CPU + GPU + NPU) |
| Memoria | Hasta 128 GB LPDDR5X-8000 · bus de 256 bits · 256 GB/s |
| Consumo | TDP de 55 W · configurable entre 45 y 120 W |
| Fabricación | TSMC 4 nm |
La clave: la memoria unificada
En un PC con tarjeta gráfica, el procesador y la gráfica tienen cada uno su memoria, y un modelo de IA tiene que caber en la de la gráfica: 24 o 32 GB en las tarjetas de consumo más potentes. En el Ryzen AI Max+ 395, la CPU y la gráfica comparten la misma memoria LPDDR5X, soldada junto al chip.
Eso permite cargar modelos que no caben en ninguna tarjeta de consumo, como gpt-oss-120b (63,4 GB) o Llama 3.3 70B (42,5 GB). La contrapartida es el ancho de banda: 256 GB/s, varias veces menos que una tarjeta gráfica de gama alta. Por eso el chip brilla con modelos que leen pocos parámetros por token. Lo explicamos con una tabla de diez modelos en ¿Cuánta memoria necesita un LLM local?
Cuánta memoria usa la gráfica en Windows y en Linux
- Windows: con el controlador AMD Software: Adrenalin Edition 25.8.1 o posterior, Variable Graphics Memory permite asignar hasta 96 GB a la gráfica en un equipo de 128 GB. Según AMD, eso basta para ejecutar en LM Studio modelos de hasta 128.000 millones de parámetros con llama.cpp sobre Vulkan, y Llama 4 Scout con 256.000 tokens de contexto.
- Linux: por defecto, la gráfica puede usar aproximadamente la mitad de la memoria. AMD documenta cómo ampliarlo con la herramienta amd-ttm y recomienda núcleos recientes (6.18.4 o posterior en la mayoría de distribuciones; Ubuntu 26.04 y Fedora 43 ya incluyen las correcciones necesarias).
El paso a paso para configurarlo y empezar a usar modelos está en Cómo ejecutar LLM en local con un Ryzen AI Max+.
Rendimiento con LLM
Estas son algunas cifras publicadas por terceros con llama.cpp. «Generación» es la velocidad que notas al chatear:
| Modelo | Tipo | Generación (tokens/s) |
|---|---|---|
| Qwen3-30B-A3B | MoE | 75,3 |
| gpt-oss-120b | MoE | 54,5 |
| Llama 4 Scout 109B | MoE | 20,2 |
| Qwen2.5 72B | Denso | 4,1 |
Fuentes: llm-tracker.info (mayo de 2025) para Qwen3 y Llama 4 Scout; ComputingForGeeks (actualizado el 14/10/2026) para gpt-oss-120b y Qwen2.5 72B. Configuraciones distintas: compara con cautela.
Con llama.cpp, el backend Vulkan procesa los prompts mucho más rápido que HIP (ROCm) en las pruebas publicadas, con una velocidad de generación parecida. Todas las cifras y sus fuentes, en Rendimiento del Ryzen AI Max+ 395 con LLM locales.
Puntos fuertes y débiles
A favor:
- Muchísima memoria para la gráfica por cada euro, sin necesidad de varias tarjetas.
- Muy buena velocidad con modelos MoE, que son la tendencia en modelos abiertos.
- Consumo contenido (45–120 W) y formato mini PC: se puede dejar encendido como servidor.
- Es un PC x86 normal: Windows o Linux, con los programas de siempre.
En contra:
- El procesamiento de prompts largos es lento comparado con NVIDIA: en la comparativa de ComputingForGeeks con gpt-oss-120b, 459 tokens/s frente a 2.444 del DGX Spark.
- Los modelos densos grandes (70B) generan a unos 4 tokens/s.
- Para atender a muchos usuarios a la vez, un equipo con CUDA y vLLM rinde mucho más.
- El ecosistema ROCm está menos maduro que CUDA para entrenar o para herramientas muy específicas.
¿Y el Ryzen AI Max+ PRO 495?
Es la evolución para profesionales: hasta 192 GB de LPDDR5X-8533 (273 GB/s), gráfica Radeon 8065S a 3000 MHz, NPU de 55 TOPS y hasta 160 GB utilizables por la gráfica. Permite modelos como Qwen3-235B, que no caben en 128 GB. Las diferencias, punto por punto, en Ryzen AI Max+ PRO 495 vs 395.
Para quién tiene sentido
- Personas y equipos pequeños que quieren chatear, programar o consultar documentos con modelos grandes sin enviar datos a la nube.
- Desarrolladores que prueban modelos abiertos y agentes en local.
- Empresas que quieren un servidor de IA pequeño y silencioso para la oficina.
No es la mejor opción si necesitas CUDA, entrenar modelos grandes o atender a decenas de usuarios a la vez.
Nuestro equipo con este procesador es el 395 Compact, refrigerado por aire y con red de 10 GbE. Si te bastan modelos de hasta unos 20.000 millones de parámetros, el HX 370 Slim (Ryzen AI 9 HX 370 y 32 GB) cuesta 1.099 €.
Fuentes
- AMD: ficha oficial del Ryzen AI Max+ 395
- AMD: Ryzen AI Max+ Upgraded: Run up to 128 Billion parameter LLMs on Windows with LM Studio (29/07/2025)
- AMD ROCm: Strix Halo system optimization
- llm-tracker.info: AMD Strix Halo GPU Performance (mayo de 2025)
- ComputingForGeeks: DGX Spark vs Strix Halo vs Mac Studio (actualizado el 14/10/2026)