Guides et analyses
Mini PC pour l'IA locale : guide d'achat 2026
Ce qui compte pour choisir un mini PC d'IA locale : la mémoire décide quels modèles tiennent, la bande passante fixe la vitesse, et le refroidissement, le réseau et la garantie font la différence au quotidien.
En bref
- La mémoire décide quels modèles vous pouvez charger : avec 128 Go, des modèles jusqu'à environ 120 milliards de paramètres ; avec 192 Go, aussi ceux de 235 milliards.
- La bande passante fixe la vitesse de génération : 256 Go/s pour le Ryzen AI Max+ 395 et 273 Go/s pour le PRO 495.
- Les modèles MoE, comme gpt-oss-120b, sont ceux qui tournent le mieux sur ces machines.
- Avant de payer, vérifiez la mémoire (elle est soudée), le prix final TVA comprise et la garantie.
Qu'est-ce qu'un mini PC pour l'IA locale ?
Un petit ordinateur conçu pour faire tourner des modèles de langage (LLM) sur votre bureau, sans envoyer vos données dans le cloud ni payer à l'usage. Ce qui le distingue d'un mini PC classique, c'est la mémoire : les modèles d'IA occupent des dizaines de gigaoctets et doivent tenir entièrement dans la mémoire utilisée par le GPU.
Les processeurs AMD Ryzen AI Max+ (la famille connue sous le nom « Strix Halo ») en sont aujourd'hui la base la plus courante. Ils réunissent sur une même puce 16 cœurs Zen 5, un GPU Radeon de 40 unités de calcul et une NPU, et partagent avec le GPU jusqu'à 128 Go (Ryzen AI Max+ 395) ou 192 Go (Ryzen AI Max+ PRO 495) de mémoire LPDDR5X.
La mémoire d'abord
Un modèle quantifié en 4 bits occupe grosso modo un peu plus de la moitié de son nombre de paramètres en gigaoctets : Llama 3.3 70B occupe environ 42,5 Go et gpt-oss-120b environ 63,4 Go. La conversation (le « contexte ») a en plus besoin de sa propre mémoire, qui grandit avec sa longueur.
La capacité est donc la première décision. Une carte graphique grand public haut de gamme offre 24 ou 32 Go, ce qui ne suffit pas pour des modèles de 70 milliards de paramètres ou plus. Avec une mémoire unifiée, le GPU utilise une grande partie de la mémoire système : sous Windows, AMD permet de lui attribuer jusqu'à 96 Go sur les machines de 128 Go, et sous Linux la répartition se règle dans le système.
Le tableau complet avec dix modèles et leur taille se trouve dans Combien de mémoire pour un LLM local ?
La bande passante fait la vitesse
Pour générer chaque token, la machine doit lire en mémoire les paramètres actifs du modèle. La vitesse maximale dépend donc surtout de la bande passante :
- Ryzen AI Max+ 395 : 256 Go/s (LPDDR5X-8000, bus 256 bits).
- Ryzen AI Max+ PRO 495 : 273 Go/s (LPDDR5X-8533).
- Une carte graphique haut de gamme dépasse 1 000 Go/s, mais avec beaucoup moins de mémoire.
C'est ce que montrent les tests publiés : les modèles MoE, qui n'activent qu'une partie de leurs paramètres à chaque token, sont rapides (gpt-oss-120b dépasse 50 tokens/s avec llama.cpp), tandis qu'un modèle dense d'environ 70 milliards de paramètres tourne autour de 4 tokens/s. Le détail dans Performances du Ryzen AI Max+ 395 avec des LLM locaux.
Les options en 2026
| Option | Mémoire pour le modèle | Points forts | Points faibles |
|---|---|---|---|
| PC avec carte graphique grand public | 24–32 Go par carte | Très rapide avec les modèles qui tiennent ; CUDA | Les grands modèles exigent plusieurs cartes ; consommation et bruit |
| Mini PC Ryzen AI Max+ 395 | Jusqu'à 96 Go sous Windows (128 Go au total) | Beaucoup de mémoire par euro ; Windows ou Linux ; faible consommation | Traite les longs prompts plus lentement que NVIDIA |
| Mini PC Ryzen AI Max+ PRO 495 | Jusqu'à 160 Go (192 Go au total) | Modèles de 235 milliards de paramètres ; un peu plus de bande passante | Prix plus élevé |
| NVIDIA DGX Spark | 128 Go | CUDA ; traite les prompts bien plus vite | Plus cher ; Linux sur Arm |
| Mac Studio | Selon la configuration | Plus de bande passante ; silencieux | macOS uniquement ; cher avec beaucoup de mémoire |
Nous comparons les trois machines de 128 Go avec des données publiées dans Ryzen AI Max+ 395 vs DGX Spark vs Mac Studio.
128 ou 192 Go ?
Avec 128 Go (Ryzen AI Max+ 395), les modèles locaux les plus utilisés pour discuter et coder tiennent avec de la marge : gpt-oss-120b, GLM-4.5-Air, Qwen3.5-122B ou Llama 3.3 70B. C'est le bon choix pour la plupart des particuliers et des petites équipes.
Les 192 Go du PRO 495 se justifient si vous voulez des modèles de plus de 200 milliards de paramètres, comme Qwen3-235B (environ 142 Go en 4 bits), ou garder plusieurs modèles chargés en même temps : un pour discuter, un pour coder et un pour chercher dans vos documents. Les différences entre les deux processeurs, point par point : Ryzen AI Max+ PRO 495 vs 395.
À noter : sur ces machines, la mémoire est soudée à côté du processeur et ne peut pas être étendue ensuite.
Refroidissement, réseau et stockage
- Refroidissement : refroidies par air, les machines sont plus compactes ; avec le refroidissement liquide, le fabricant permet de régler le processeur entre 45 et 120 W pour tenir la cadence lors de longues sessions. Si la machine doit servir des heures d'affilée, le liquide est le choix naturel.
- Réseau : en 10 GbE, un modèle de 60 Go se copie en une minute environ dans des conditions idéales, contre environ 8 minutes en 1 GbE. Pour servir des modèles à tout le bureau, le réseau compte.
- Stockage : un grand modèle occupe 60 à 150 Go. 1 To en accueille quelques-uns, et les emplacements M.2 libres permettent d'étendre.
Système et logiciels
AMD prend en charge ces processeurs sous Windows 11 et sous Linux (Ubuntu et Red Hat). Pour débuter, LM Studio permet de télécharger et d'utiliser un modèle en quelques clics ; Ollama et llama.cpp sont les outils habituels pour servir des modèles à d'autres ordinateurs. Pas à pas dans Faire tourner des LLM en local sur un Ryzen AI Max+.
Ce qu'il faut vérifier en achetant en Europe
- La mémoire exacte : elle est soudée, choisissez donc la capacité en pensant aux modèles que vous voudrez utiliser dans quelques années.
- Le prix final : si vous achetez hors de l'UE, vous pouvez devoir payer la TVA et des droits d'importation à la livraison.
- La facture : pour un achat professionnel, demandez une facture à vos coordonnées fiscales.
- Garantie et retour : dans l'UE, vous disposez de 14 jours pour vous rétracter d'un achat à distance ; pour les achats chez nous s'applique la garantie légale de 3 ans du droit espagnol.
- Le support : pouvoir demander avant d'acheter si la machine convient à ce que vous voulez faire tourner.
Notre recommandation selon votre profil
- Débuter avec un petit budget : le HX 370 Slim (Ryzen AI 9 HX 370 et 32 Go) fait tourner des modèles jusqu'à environ 20 milliards de paramètres, comme gpt-oss-20b, pour 1 099 €.
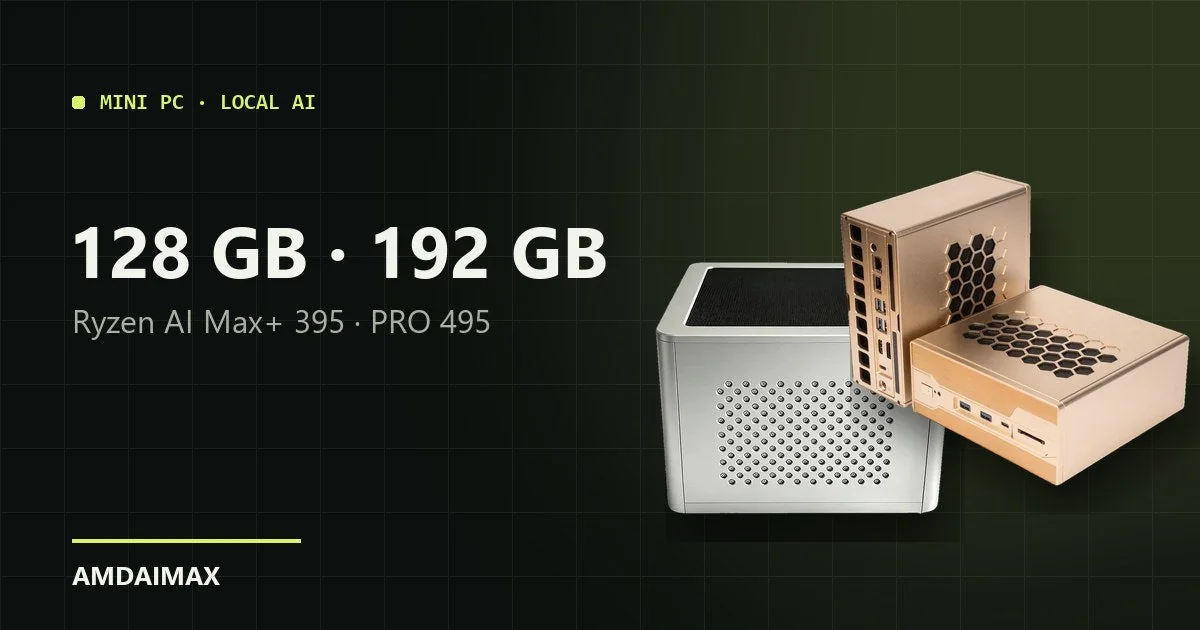
- Se lancer sérieusement dans l'IA locale, seul ou en petite équipe : un Ryzen AI Max+ 395 avec 128 Go. Refroidi par air et avec réseau 10 GbE : le 395 Compact.
- Modèles de plus de 200 milliards de paramètres ou plusieurs à la fois : le PRO 495 Gold (192 Go et 10 GbE).
- Si vous avez besoin de CUDA ou de servir beaucoup d'utilisateurs à la fois : regardez un DGX Spark ou un PC équipé de cartes NVIDIA.
Données des processeurs : fiches officielles d'AMD. Tailles des modèles : fichiers GGUF publiés sur Hugging Face, mesurés le 19/10/2026. Vitesses : tests publiés par des tiers, cités dans les articles liés.