Ratgeber und Analysen
Ratgeber und Analysen zu lokaler KI mit Mini-PCs mit AMD Ryzen AI: welche Modelle in 32, 128 und 192 GB passen, echte Leistung, Vergleiche und der Einstieg.
Fragen an deine Dokumente mit lokaler KI: RAG mit Open WebUI
So richtest du eine KI-Suche über deine eigenen Dokumente ein: welche Modelle du lädst, wie du in Open WebUI eine Wissensdatenbank anlegst, welche Einstellungen zählen und wie du prüfst, dass...
Lesen →
Lokale KI im Unternehmen: Datenschutz, DSGVO und Kostenkontrolle
Was sich ändert, wenn KI-Modelle auf einem Rechner im eigenen Unternehmen laufen: Die Daten bleiben im Büro, es gibt weniger Dritte, die Kosten sind planbar – und die DSGVO verlangt...
Lesen →
Lokale LLMs auf einem Ryzen AI Max+ ausführen: LM Studio, Ollama und llama.cpp
Schritt-für-Schritt-Anleitung: wie du der Grafik unter Windows und Linux Speicher zuweist und mit LM Studio, Ollama und llama.cpp große Modelle nutzt – und sie dem ganzen Büro bereitstellst.
Lesen →
AMD Ryzen AI Max+ 395 (Strix Halo) für lokale KI: was du wissen musst
Was der Ryzen AI Max+ 395 ist, warum ihn seine 128 GB Unified Memory für lokale KI besonders machen, wie schnell er laut veröffentlichten Tests mit LLMs ist und wo...
Lesen →
Wie viel Speicher braucht ein lokales LLM? Tabelle mit 10 Modellen
Wie viel jedes Modell in 4 Bit belegt, wie viel Speicher der Kontext dazu braucht und was in eine Grafikkarte mit 24 oder 32 GB passt – im Vergleich zu...
Lesen →
Mini-PC für lokale KI: Kaufberatung 2026
Worauf es bei einem Mini-PC für lokale KI ankommt: Der Speicher entscheidet, welche Modelle passen, die Bandbreite bestimmt das Tempo, und Kühlung, Netzwerk und Gewährleistung machen im Alltag den Unterschied.
Lesen →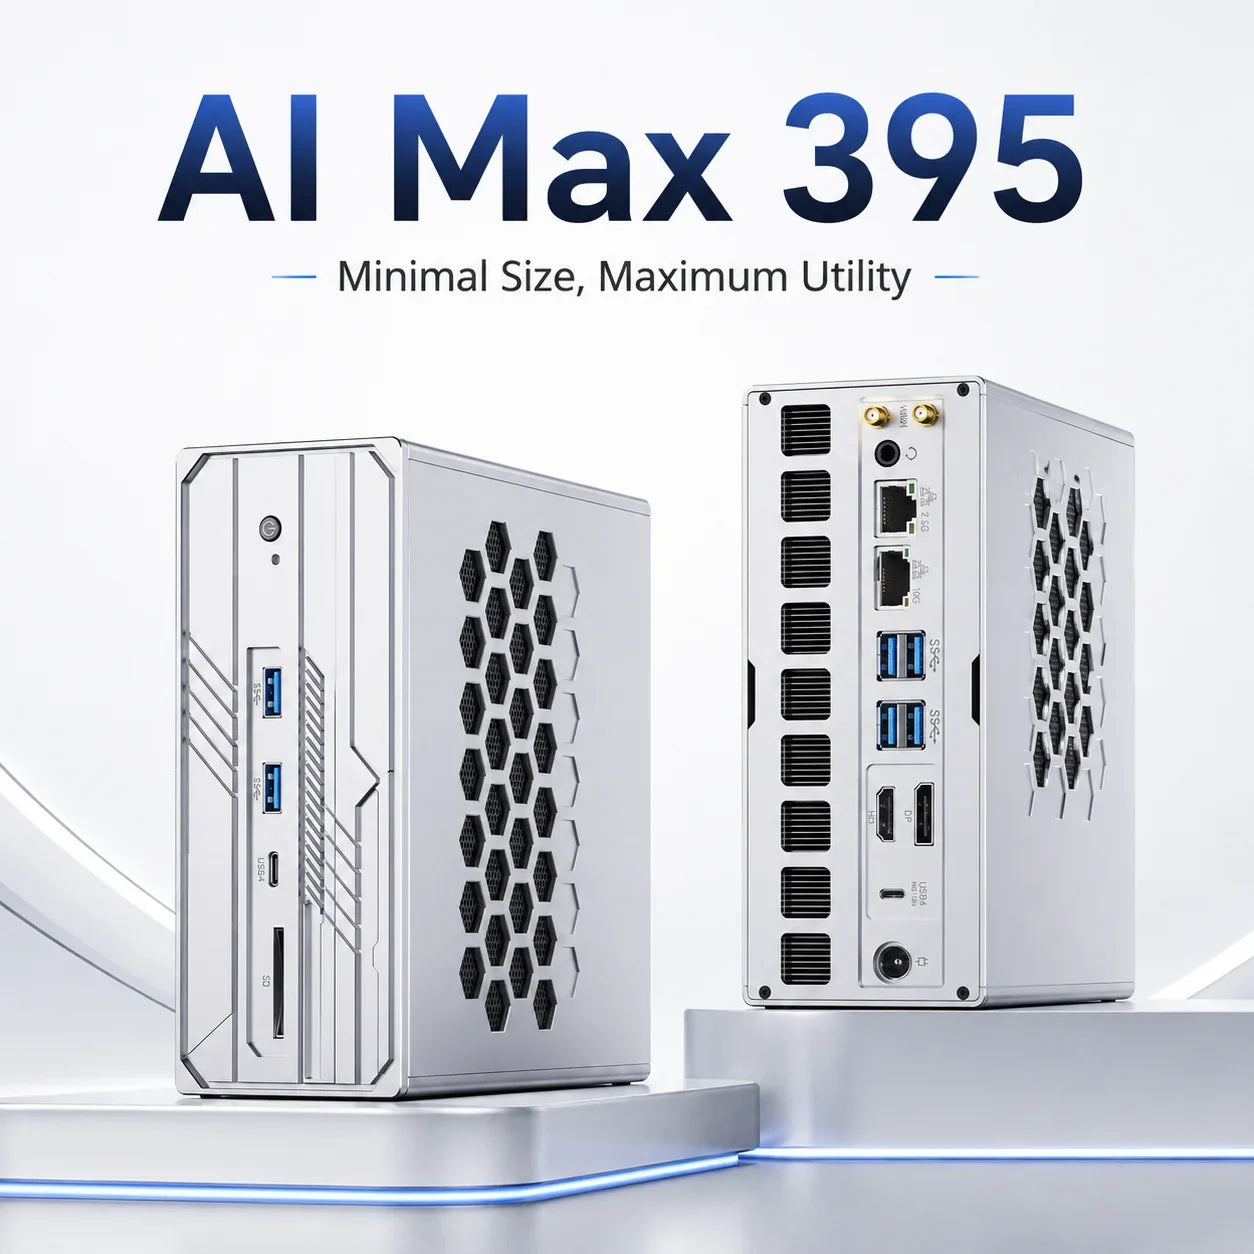
Ryzen AI Max+ 395 vs. DGX Spark vs. Mac Studio: Was kaufen für lokale KI?
Drei Rechner mit 128 GB für lokale KI im Vergleich anhand veröffentlichter Daten: Generierungsgeschwindigkeit, Prompt-Verarbeitung, Bandbreite und Preis.
Lesen →
Leistung des Ryzen AI Max+ 395 mit lokalen LLMs: veröffentlichte Daten
Wir haben veröffentlichte Tests mit llama.cpp zusammengetragen: schnelle MoE-Modelle (über 50 Tokens/s mit gpt-oss-120b) und deutlich langsamere dichte 70B-Modelle (rund 4 Tokens/s).
Lesen →
Ryzen AI Max+ PRO 495 vs. Ryzen AI Max+ 395: Was sich für lokale KI ändert
Wir vergleichen die offiziellen Daten der beiden AMD-Prozessoren für lokale KI: mehr Speicher (192 GB statt 128 GB) und etwas mehr Bandbreite beim 495.
Lesen →